Sprechen wir Klartext!
Anamnesebögen und die schwierige computergestützte Standardisierung von Gesundheitsdaten in der Bundesrepublik der 1970er Jahre
Source profile
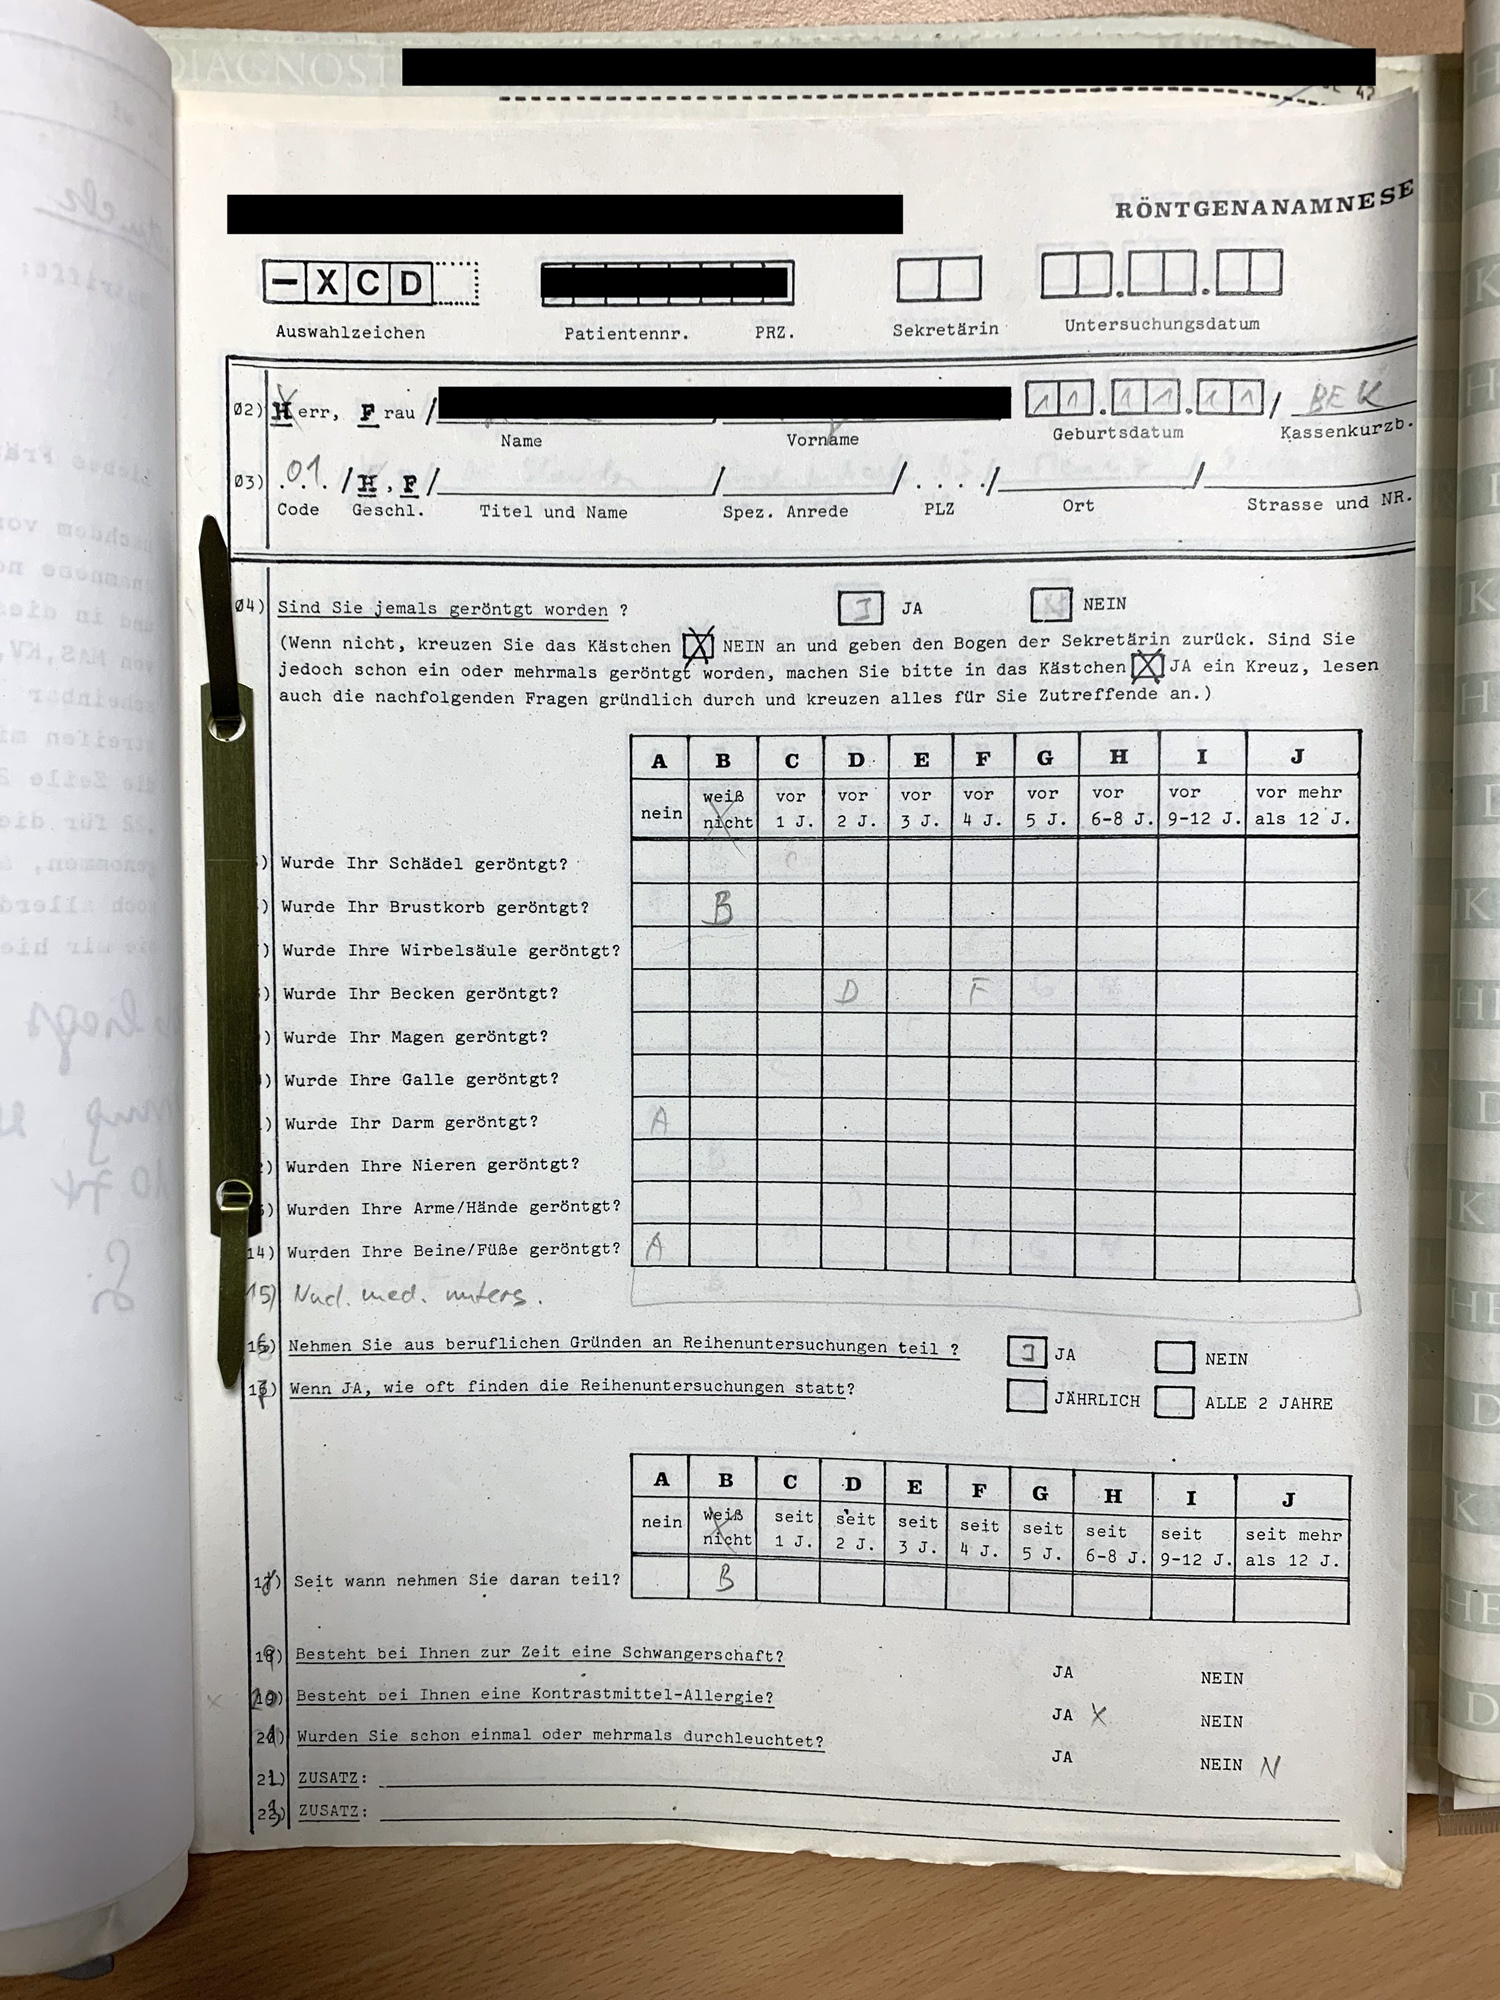
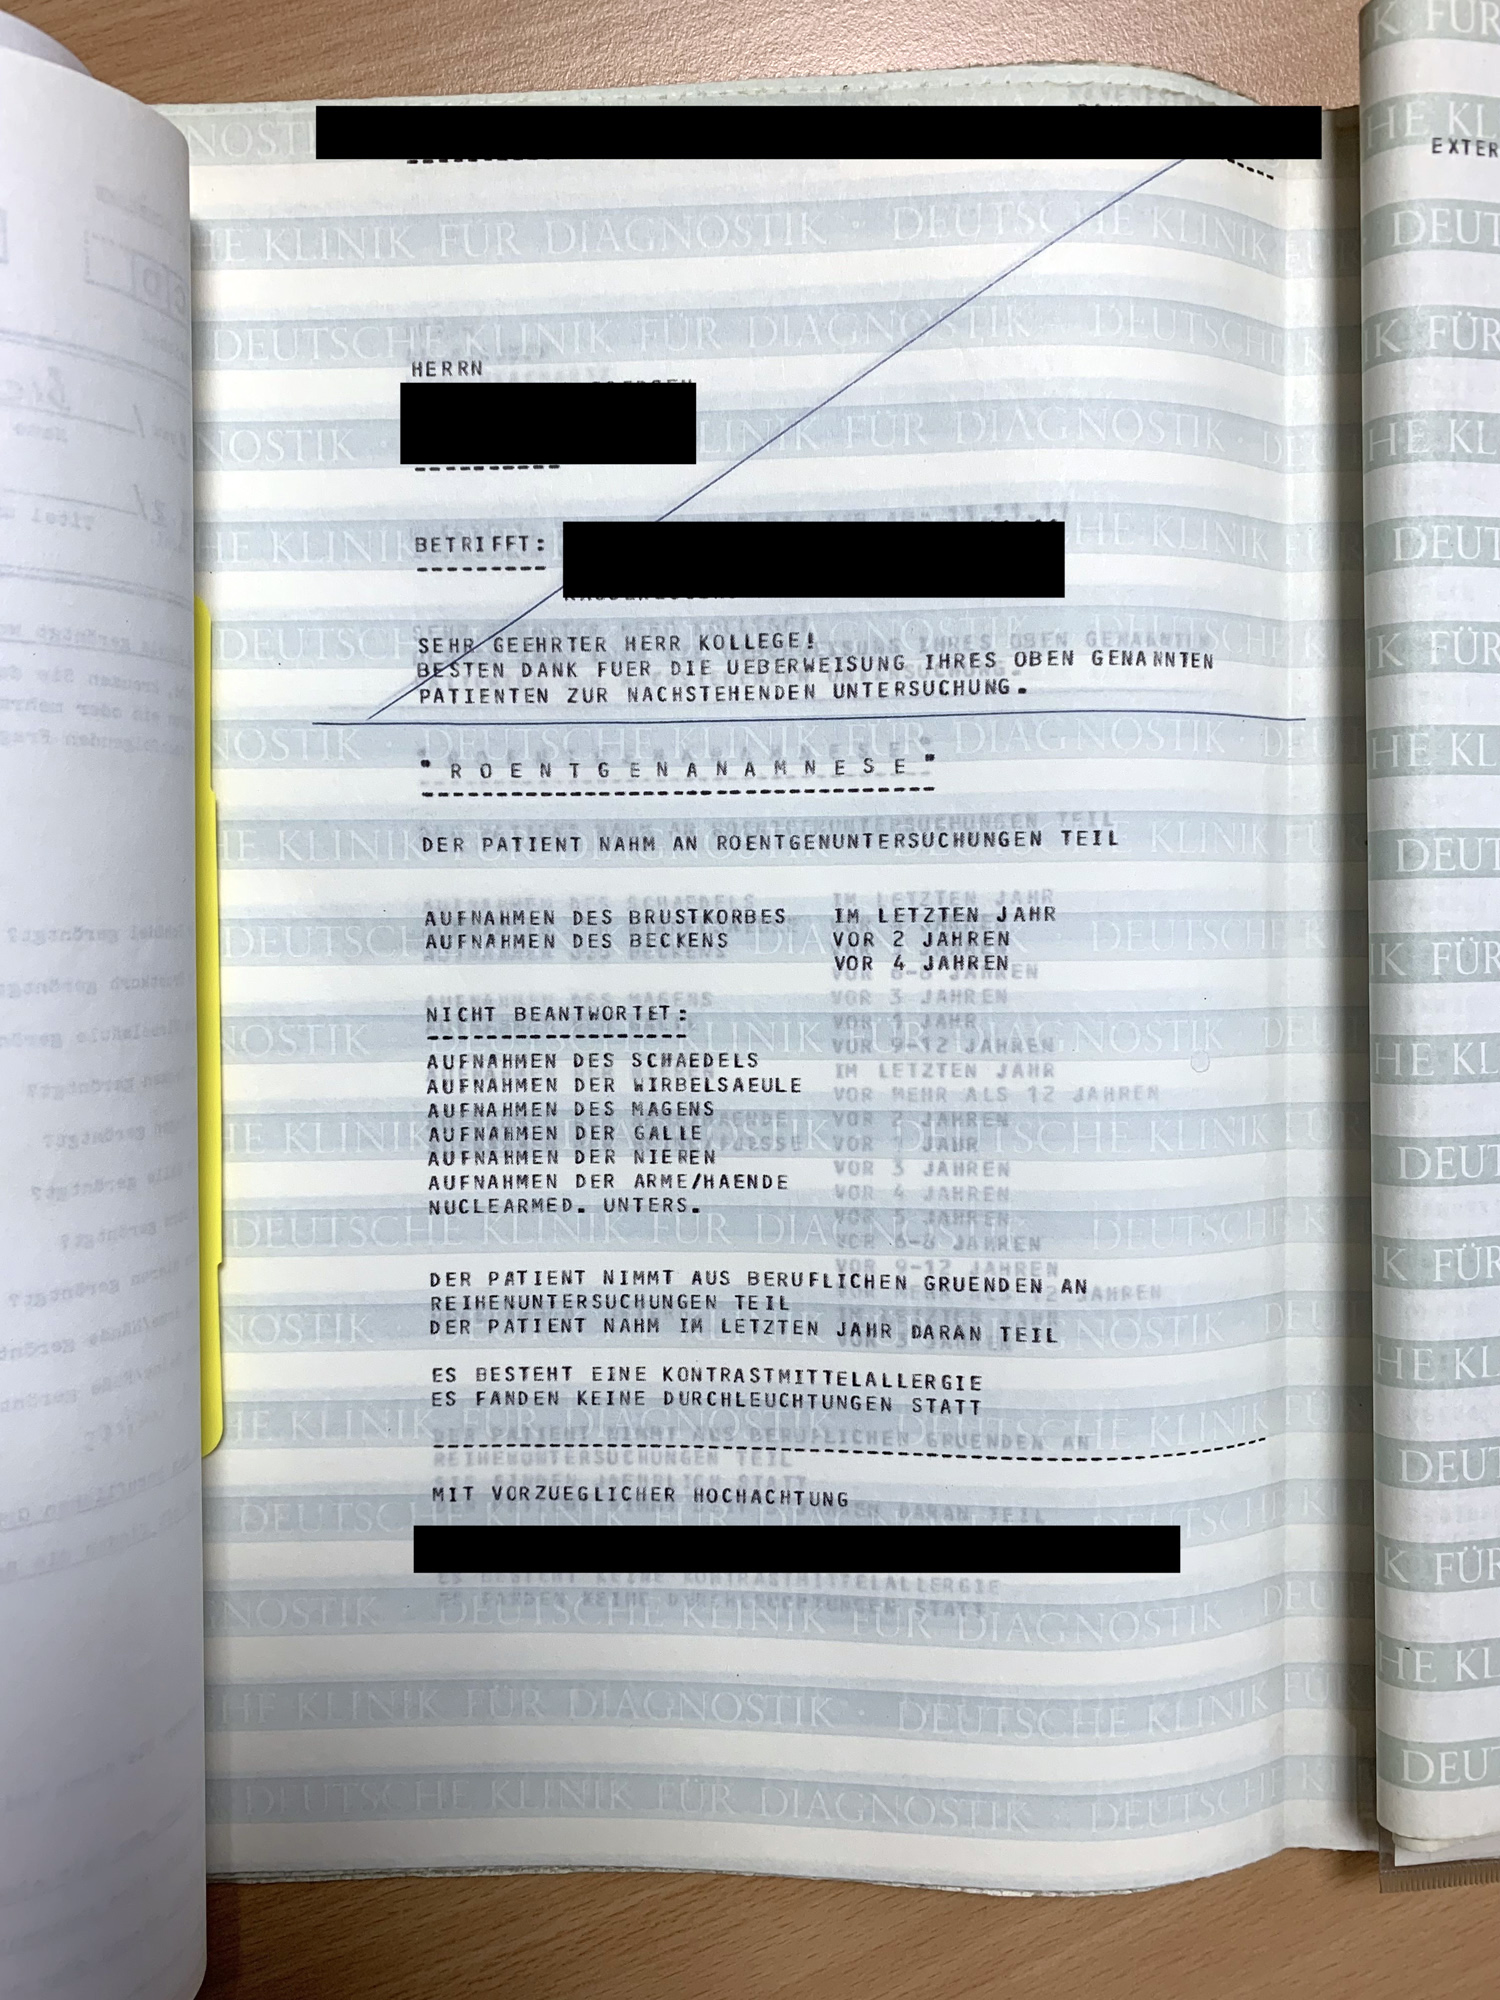
Erhebungsbogen für eine Röntgenanamnese sowie dessen per Computernetzwerk übermittelte elektronische Version- aus
- DIPAS-Projekt, Cochem/Wiesbaden 1973
- Institut
- Deutsches Institut für Mikrofilm, Leisnig (DE, Sachsen). Sammlung Wolfgang Giere (ORDAB-0003–5131, hier 0003)
Es ist seit Jahrzehnten eines jener kaum hinterfragten Rituale, die eine medizinische Erstbehandlung mit sich bringt: Man betritt die Arztpraxis, wird vom Praxisteam mit einem Klemmbrett begrüßt und gebeten, im Wartezimmer Platz zu nehmen – und den beiliegenden Bogen auszufüllen. Auf mehreren Seiten soll man über Multiple-Choice-Antworten und einige Freifelder seine Krankengeschichte in Form bringen. Was mit diesen Bögen passiert, scheint zumindest rätselhaft. Es gilt im Sprechzimmer im Nachgang meist erneut, die Symptome zu schildern; aus den Anamnesebögen, die von Allergien bis zu Erbkrankheiten viele Register ziehen, scheint also oft keine Konsequenz zu erwachsen. Das hat nicht nur damit zu tun, dass viele Patient:innen die Fragen nicht so umfassend beantworten (können). Die Bögen werden von den behandelnden Ärzt:innen in der Regel ohnehin eher nur mit einem Seitenblick zur Kenntnis genommen. Für wen also sind diese Bögen?
Die Antwort führt zurück bis zu einem medizininformatischen Projekt in Rheinland-Pfalz und Hessen in den 1970er Jahren und zwei Musterbögen für einen Patienten (geb. 11.11.1911; vermutlich fiktiv, Praxis und Patient sind dennoch anonymisiert), mit denen diese Geschichte beginnt: Bei dem einen Musterbogen handelt es sich um einen Vordruck, mit ausgefüllten Kästchen, bei dem anderen um ein engmaschig beschriftetes Druckdokument, in dem offenkundig dieselben Informationen maschinenlesbar auf einem durchlaufenden dünnen Papier zusammengeführt worden sind, auf dem im Hintergrund immer wiederkehrend »Deutsche Klinik für Diagnostik« steht.
Die beiden Dokumente stammen aus der Privatsammlung des MedizininformatikersWolfgang Giere,1 die im Jahr 2023 im Deutschen Institut für Mikrofilm in Leisnig aufbewahrt wurde. Neben Projektunterlagen und Korrespondenzen enthält sie zahlreiche Testdrucke aus frühen Computerisierungsprojekten. Sie dokumentieren eine zentrale Transformation der bundesdeutschen Medizin: die Einführung computergestützter Dokumentation in Praxen und Kliniken.2
Im vorliegenden Beitrag wird danach gefragt, wie Anamnesebögen seit den 1970er Jahren zu einem zentralen Instrument der computergestützten Erfassung von Gesundheitsdaten wurden und welche Probleme mit der Standardisierung medizinischer Informationen verbunden waren. Ausgehend vom DIPAS-Projekt werden zunächst die Entstehung früher digitaler Dokumentationsformen und ihre technischen Voraussetzungen untersucht, bevor die Folgen dieser Standardisierung für medizinisches Wissen, Patient:innen und aktuelle Debatten um digitale Gesundheitsdaten diskutiert werden.
Mainz, 1972: Ein Netzwerk auf dem Weg ins Computerzeitalter
Der Ausgangspunkt liegt in Mainz bei einem Bundesforschungsprojekt, das schnörkelloser nicht hätte klingen können: EDAP: »Einführung der Datenverarbeitung in die ärztliche Praxis«. Dieses Projekt stand in den frühen 1970er Jahren im Kontext des zweiten Datenverarbeitungsprogramms der Bundesregierung sowie diverser Vereinsgründungen und einer Initiative, um die Einführung der Datenverarbeitung bei niedergelassenen Ärzt:innen voranzutreiben. Von 1972 bis 1975 vernetzten zwei technisch affine Ärzte niedergelassene Praxen in Hessen, Rheinland-Pfalz, NRW und Baden-Württemberg mit einem Rechenzentrum in Wiesbaden.
Der Mediziner und spätere Frankfurter Medizininformatik-Professor Giere, Leiter des Teilprojekts DIPAS (»Dokumentations- und Informationsverbesserung für den Arzt durch EDV-Service«) und damals Leiter des Rechenzentrums der Deutschen Klinik für Diagnostik in Wiesbaden, sowie der Internist Otfrid P. Schaefer, Leiter des Teilprojekts INA (»Informationssystem für den niedergelassenen Arzt«), wollten erforschen, wie sich ärztliche Befunde, Anamnesebögen und Arztbriefe computergestützt erfassen und übertragen lassen. Mit einer Fördersumme von 2,5 Millionen DM vom Bundesministerium für Forschung und Technologie ausgestattet, war EDAP ein besonderes Netzwerkprojekt in jener Zeit, weil es »von unten« konzipiert werden sollte.3
Giere und Schaefer warben mit Anzeigen in Fachzeitschriften und persönlicher Ansprache – und die Ärzt:innen, die sich meldeten, taten es aus eigenem Antrieb. Am Ende zählte DIPAS über 30 Partnerpraxen: von Einzelpraxen auf dem Land über Ärztehäuser in Kreisstädten bis hin zu Fachpraxen in den Großstädten. Die ärztlichen Teilnehmer:innen sollten die Informationsvorgänge in ihren Praxen erheben, Leitungen zum Rechenzentrum der Deutschen Klinik für Diagnostik nach Wiesbaden legen lassen (Abb. 3), neue maschinenlesbare Dokumente für Gesundheitsdaten entwerfen, elektronische Befunde hin- und herschicken und vor allem auch in regelmäßigen Gremiensitzungen ihre Erfahrungen mit dem System besprechen. Das Schaubild aus dem Projektantrag macht deutlich, dass die Standardisierung medizinischer Daten von Beginn an als zentralisiertes Vernetzungsprojekt gedacht war, bei dem Informationen über das Rechenzentrum in ein gemeinsames System eingespeist werden sollten.
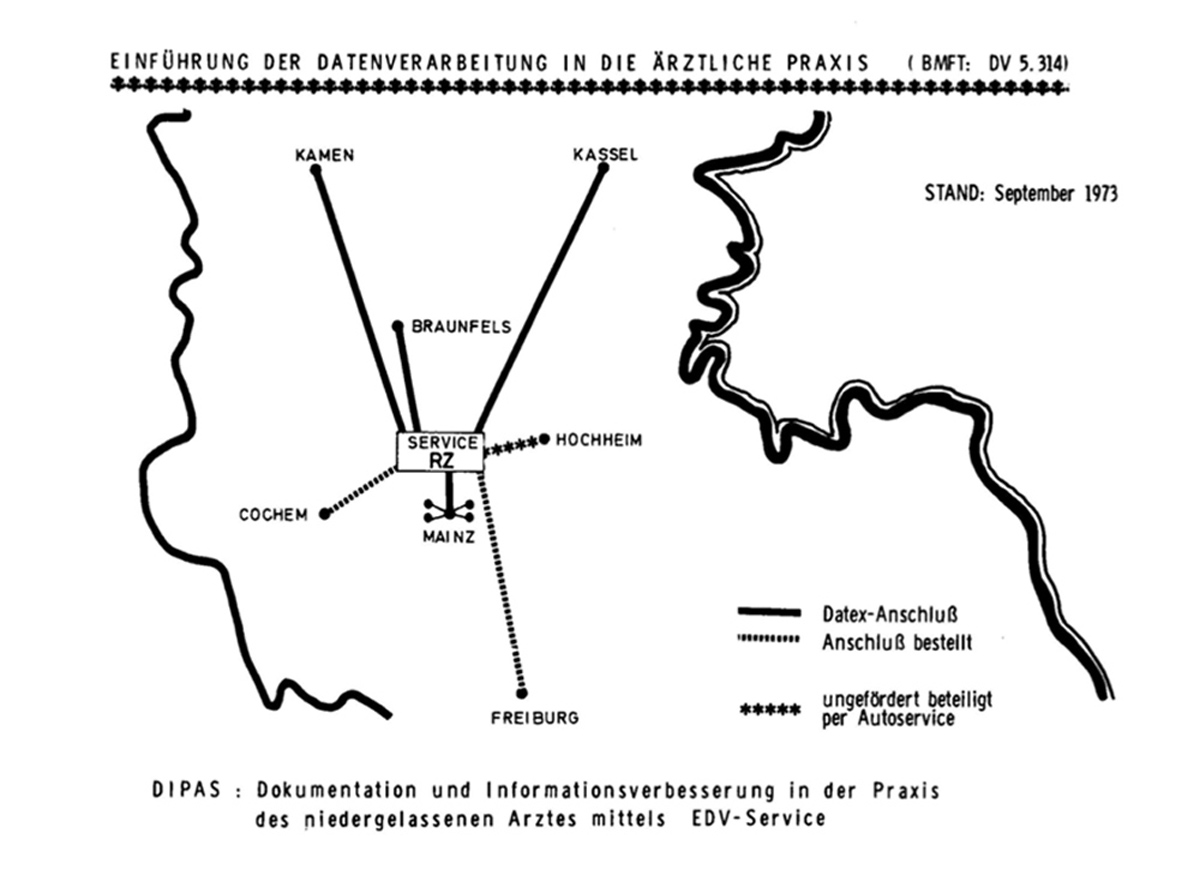
Unter den Beteiligten waren Radiologen, Kinderärzte oder Lungenfachärzte, die sich aktiv entschieden hatten, dem Computer zu »erklären«, was in ihren Sprechzimmern vorging. Ein wesentlicher Beweggrund war, dass die Verarbeitung der Informationen, die sie täglich aufnehmen mussten, sowie die Dokumentation des Wissensstands, der für eine zeitgemäße Behandlung notwendig war, für die Praxen zunehmend nicht mehr ohne den Einsatz von Datenbanken zu bewältigen war. Man hoffte, Zeit zu sparen, die man dann für die Patient:innen aufwenden konnte. Das dabei zutage tretende Dilemma war allerdings wortwörtlich vorprogrammiert: Das Deutsche Ärzteblatt hielt 1973 nüchtern fest, dass es »nicht den Anamnesefragebogen für alle Ärzte und für alle Patienten« geben könne.4 Und doch mussten Formulare entwickelt werden, die für möglichst viele Fälle passten.
Innerhalb der Ärzteschaft gab es seit den frühen 1970er Jahren Bestrebungen, Praxis- und Klinikabläufe effizienter zu gestalten und Dokumentationskosten zu senken – gleichzeitig erhöhte der Staat mit ersten Kostendämpfungsmaßnahmen im Gesundheitswesen den Druck von außen, die sogenannte (Techno-)Rationalisierung trieb den Auf- und Ausbau der Medizinnetzwerke an. Der standardisierte Bogen war damit nicht nur ein technisches Instrument, sondern auch ein wirtschaftliches: Er sollte das Arzt-Patienten-Gespräch auf die zur Abrechnung relevanten Faktoren verdichten und es für eine diagnostisch geleitete Form der Gesprächsführung vorbereiten. Der Computer war hier das Werkzeug dieser Optimierung. Viele Verbände für Rationalisierung in der Medizin – etwa die A.R.O. (Arbeitsgemeinschaft zur Rationalisierung in der Arztpraxis/Gesundheitswesen), in der Schaefer in Hessen aktiv war – legten eigene Formulare vor, die sich übernehmen ließen.5
Allerdings war die Optimierung durch Standardisierung kein einfaches Unterfangen. Die Kinderärzte im Team stellten bei frühen Entwürfen etwa fest, dass Bögen, die für Erwachsene konzipiert wurden, bei Kindern versagten: Es fehlten etwa Felder für die neurologische Entwicklung, für Sprache oder zur psychologischen Diagnostik. Aber auch andere Fachärzt:innen kritisierten die Entwürfe. Häufige Vorgeschichten der Patient:innen wurden nicht abgefragt, eher seltene Vorkommnisse nahmen mitunter überproportional viel Platz ein. DIPAS war damit ein Spiegel im Kleinen für ein Problem im Großen: Die Standardisierung der medizinischen Dokumentation generierte ebenso viele blinde Flecken wie neue Informationen. An den Bögen lässt sich damit beobachten, welche Erfahrungen in digitale Systeme übersetzt werden konnten und welche nicht.
Die Sprache, die man nicht sprechen darf
Wie DIPAS anschaulich macht, war das Kernproblem der medizinischen Dokumentation seit den Anfängen der Computerisierung nicht in erster Linie technischer, sondern sprachlicher Natur. Ärzt:innen erfassen Krankheiten in Gesprächen, Beobachtungen und Beschreibungen, ihre Arbeit beruht auf einer Sprache voller Nuancen und situativer Einschätzungen. Computer hingegen benötigen Eindeutigkeit. Damit medizinische Informationen gespeichert, durchsucht oder zwischen verschiedenen Einrichtungen ausgetauscht werden konnten, mussten sie zunächst in eine standardisierte Form übersetzt werden.
Der Anamnesebogen erfüllte dabei mehrere Funktionen zugleich. Für Patient:innen half er bei der Vorbereitung auf das Arztgespräch und dabei, Beschwerden, Vorerkrankungen oder Medikationen systematisch zu erinnern. Für Ärzt:innen diente er als Grundlage der Dokumentation und konnte Informationen für Arztbriefe, Befundberichte oder Überweisungen vorstrukturieren und damit auch techno-rationalisiert einsetzbar machen. Im Fall von DIPAS wurde der Bogen jedoch zugleich zu einem Instrument, um medizinische Informationen in eine Form zu überführen, die Computer speichern, übertragen und weiterverarbeiten konnten. Die zukünftige Aufgabe der Datenbanken lag darin, das differentialdiagnostische Wissen der Medizin zu bündeln, zu fragmentieren und abrufbar zu machen.
Die genannten Zielsetzungen standen jedoch nicht immer im Einklang. Während das Arzt-Patienten-Gespräch Offenheit und individuelle Beschreibung erforderte, verlangten Arztbriefsysteme und computergestützte Dokumentation zunehmend standardisierte Angaben. Die Herausforderung für die DIPAS-Ärzt:innen bestand somit darin, die Vielfalt medizinischer Beobachtungen in eine gemeinsame Sprache zu überführen. Der Lungenfacharzt im Projekt verdeutlichte dieses Problem anhand seiner »Hustenanamnese«.6 Wie er u.a. in Berichten diskutierte, umfasst der Begriff »Husten« diagnostisch sehr unterschiedliche Phänomene. Für ihn bestand die Herausforderung darin, diese Unterschiede so zu dokumentieren, dass sie auch innerhalb computergestützter Systeme nachvollziehbar blieben.
Hierin lag das zentrale Dilemma der frühen Medizininformatik. Erst die Etablierung gemeinsamer Begriffe, Kategorien und Dokumentationsstandards ermöglichte elektronische Arztbriefe, Datenbanken oder die spätere Vernetzung medizinischer Einrichtungen. Ohne Standardisierung wäre die digitale Medizin in ihrer heutigen Form kaum denkbar gewesen. Zugleich erzeugte dieser Ansatz jedoch neue Grenzen dessen, was dokumentiert werden konnte. Nicht, weil einzelne Ärzt:innen Informationen bewusst ausblenden wollten, sondern weil Informationssysteme nur mit dem arbeiten konnten, was in ihrer Sprache überhaupt vorgesehen war. Der Medizininformatiker Albin Proppe sah hierin eines der Grundprobleme der frühen Computerisierung der Medizin. Viele Ärzt:innen bewegten sich seiner Ansicht nach im »leeren Raum geträumten Vorstellungen« über die Möglichkeiten des Computers,7 ohne die Logiken zu kennen, nach denen technische Systeme Informationen ordneten und verarbeiteten.
Für die erste Generation der Medizininformatiker:innen, die häufig selbst medizinisch ausgebildet war, bestand die Lösung deshalb nicht allein im Einsatz neuer Technik. Sie versuchte vielmehr, zwischen zwei unterschiedlichen Sprachwelten zu vermitteln: der offenen, erfahrungsbasierten Sprache der Medizin und der formalisierten Sprache der Datenverarbeitung. Projekte wie DIPAS sollten dies vorantreiben. Abseits solcher Modellprojekte hatten die meisten Mediziner:innen allerdings nur begrenzten Einfluss auf die entstehenden Standards. Sie arbeiteten mit den Dokumentationssystemen, die ihnen von Softwareanbietern, Kliniken oder späteren Praxisverwaltungssystemen zur Verfügung gestellt wurden.
Viele begegneten dieser Entwicklung zunächst mit Skepsis. Die Anschaffungskosten waren erheblich, der zusätzliche Dokumentationsaufwand hoch und der konkrete Nutzen keineswegs selbstverständlich. So lässt sich für die Bundesrepublik feststellen, dass trotz Beratungsstellen für EDV oder der lange laufenden »PC«-Beilage des Deutschen Ärzteblatts (Abb. 4) die Adaption von Praxiscomputern und der Anschluss von Praxen an Landes- oder Bundesnetzwerke nur stark verzögert eintrat.8 Aus historischer Perspektive verweist dieses Übersetzungsproblem auf einen bislang wenig beachteten Aspekt digitaler Ungleichheit. Entscheidend war nicht nur, wer Zugang zu digitalen Systemen besaß. Historisch lässt sich vielmehr auch untersuchen, welche Schicksale, Symptome und Krankheitsverläufe überhaupt dokumentierbar wurden und welche, mangels sprachlicher Repräsentanz, im Dunkeln blieben. Dies war im Alltag, in dem die Anamnesebögen ohnehin nur dem Gespräch vorgelagert waren, zunächst noch nicht weiter problematisch. Es gab in den Praxen in der Regel handschriftliche Krankenakten, in denen im »Klartext« bzw. »Freitext« das Krankheitsbild der Patient:innen verschriftlicht werden konnte. Auch Arztbriefe, die viel Zeit in Anspruch nahmen, ließen noch persönliche Notizen zu.
Die elektronische Speicherung von Gesundheitsdaten eröffnete aber auch neue Debatten über Datenschutz,9 Schweigepflicht und informationelle Selbstbestimmung.10 Seit den 1970er Jahren wurde daher nicht nur diskutiert, wie Patient:innen computergestützt erfasst werden könnten, sondern auch, ob und unter welchen Bedingungen dies juristisch geschehen sollte. Die Figuren des »gläsernen Patienten« und des »Kollege Computer« begleiteten hierbei die Computerisierung der Medizin von Beginn an kritisch.11
Bundesbürger:innen sollten zu jedem Zeitpunkt über das Erheben, Verwerten und Weitergeben ihrer persönlichen (medizinischen) Daten selbst entscheiden können – man gestand ihnen ein Recht auf (digitale) Privatsphäre im Informationszeitalter zu. Die Möglichkeit, Gesundheitsdaten elektronisch zu speichern und über Netzwerke standardisiert zu übertragen, brachte somit eine politische Dimension der Dokumentation ins Spiel: Wer sollte Zugriff auf diese Informationen erhalten? Hier wurden nicht nur Fragen der Schweigepflicht (gegenüber Dritten und dem Computer) neu diskutiert, sondern auch die Krankenkassen sorgten mit ihrer eigenen techno-rationalisierten Form der Datenverarbeitung für zusätzliche Konflikte.12
Für viele Akteur:innen in jener Zeit ergab sich somit nicht nur die Frage, wie man Patient:innen computertechnisch erfassen konnte, sondern auch, ob man dies überhaupt sollte. Aus heutiger Perspektive ist dabei wichtig, dass in der Folge jahrzehntelang hybride Dokumentationsformen existierten, in denen standardisierte Bögen, Freitextakten und persönliche Arztbriefe nebeneinander genutzt wurden. Gleichwohl zeigte sich für viele Beteiligte zunehmend, dass die wachsende Menge medizinischer Informationen ohne Formen der Standardisierung kaum noch zu bewältigen war. Dies bedeutete jedoch auch, dass sich eine Ungleichheit in die Datensätze einschreiben musste.
»Häufiges ist häufig« – und Seltenes fällt durch das Raster
Bereits 1970 hatte der Medizininformatiker Siegfried Koller13 von einer regelrechten »Informationslawine« gesprochen, die sich »zunächst im exponentiellen Anschwellen des Schrifttums mit einer Verdopplung in jeweils etwa zehn Jahren« gezeigt hätte.14 In einem Artikel im Deutschen Ärzteblatt, übertitelt mit der Frage »Fluch oder Segen?«, betonte Koller zunächst die positiven Möglichkeiten eines vielleicht bald bevorstehenden »goldene[n] Informationszeitalters«.15 In diesem stünden große, zentrale Datenbanken zur Verfügung, die man in den USA bereits nutzen könnte. Auch andere Medizininformatiker:innen jener Zeit waren überzeugt, dass mit solchen Datenbanken Informationen »besser, schneller, einfacher, vollständiger oder preiswerter« zugänglich gemacht werden könnten.16
Das Kalkül, medizinisches Fachwissen über Praxis-, Klinik- und Institutionengrenzen verfügbar zu machen, blieb allerdings zunächst eher Vision als umsetzbare Realität. Die Standardisierung der Anamnesebögen war nur ein erster Schritt; Informationen mussten nicht nur erhoben, sondern auch gespeichert, verknüpft und wieder auffindbar gemacht werden. Obschon die Datenbanken erfolgreich konzipiert wurden und stetig zunahmen, wurde bald deutlich, dass sie nur so gut sein konnten wie ihre internen Verknüpfungen und Suchstrukturen. International entstanden deshalb sogenannte Thesauren, gewissermaßen Wörterbücher für Computer. Das DIPAS- sowie das INA-Team hatten hierfür etwa einen Projektmitarbeiter, der bestehende Thesauren einsatzbereit machte.17 Die Programmiererinnen des Projekts und die Mitarbeiterinnen der Praxen, zwei heute oft übersehene Gruppen von Frauen in der frühen Computerisierung der Medizin,18 entwickelten auf dieser Grundlage lokale Datenbankkonfigurationen für die beteiligten Arztpraxen. Die Praxen konnten dadurch Patient:innenakten und die daraus resultierenden Berichte oder Abrechnungen zunehmend elektronisch verwalten. Auch kommerzielle Anbieter entsprechender Software drängten auf den Markt.
Institutionen wie das Deutsche Institut für Medizinische Dokumentation und Information (DIMDI) ermöglichten den Zugang zu nationalen und internationalen Datenbanken.19 Parallel entstanden Diskussionen über bundesweite Gesundheitsdateninfrastrukturen, die bis heute fortwirken.20 Die neuen Datenbanken versprachen hierbei medizinisches Wissen nicht nur zu sammeln, sondern auch zu ordnen. Damit stellte sich zwangsläufig die Frage, welche Informationen im Zentrum und welche an den Rändern solcher Systeme stehen sollten. In der Entwicklung dieser Informationssysteme wurde deshalb ein ursprünglich pragmatischer Grundsatz der medizinischen Ausbildung zunehmend zu einem Strukturprinzip digitaler Wissensorganisation: »Häufiges ist häufig, Seltenes ist selten«. Viele Datenbanken orientierten sich an Wahrscheinlichkeiten.21
Dieser Ansatz erschien diagnostisch plausibel. Ärzt:innen sollten zunächst an die wahrscheinlichsten Ursachen eines Symptoms denken, und Datenbanken erlaubten es, große Wissensmengen im Prozess der Standardisierung überhaupt erst handhabbar zu machen. Gerade diese Priorisierung hatte jedoch Folgen. Was häufig vorkam, erhielt mehr Raum in Dokumentationssystemen und Suchstrukturen. Was selten vorkam, wurde zwar nicht ausgeschlossen, aber in aller Regel weniger detailliert berücksichtigt. Dabei führten die neuen Datenbanken vielfach fort, was medizinische Handbücher und Nachschlagewerke bereits seit Jahrzehnten vorgaben.22
Digitale Systeme erbten bestehende Wissensordnungen und verstärkten sie teilweise durch ihre Suchlogiken und Dokumentationsstandards. Quellen zur Standardisierung medizinischen Wissens, die von Korrespondenzen der Mediziner:innen und Techniker:innen bis hin zu Formularen und Testausdrucken aus Datenbanken reichen, erlauben eine Analyse der Faktoren digitaler Ungleichheit, die über Fragen des Zugangs zu Technik hinausreicht. Sie machen sichtbar, wie Kategorien, Dokumentationsstandards und Informationssysteme entstanden und wie dabei bestimmte Formen medizinischen Wissens bevorzugt, andere hingegen an den Rand gedrängt wurden.
Eine unausgesprochene Ungleichheit
Digitale Ungleichheit wird oft als Frage des Zugangs einer »digital underclass« zu Hardware und Know-how gedacht: Wer hat ein Endgerät, wer einen Internetanschluss, wer kann eine Benutzeroberfläche bedienen, wer versteht etwas von Algorithmen?23 Die Geschichte der medizinischen Computerdokumentation verweist auf eine andere, weniger sichtbare Form von Ungleichheit. Hier geht es nicht um die Frage, wer Zugang zum System hat, also nicht um den »digital divide«,24 sondern darum, ob das System überhaupt eine Sprache für bestimmte Erfahrungen, Krankheitsbilder oder Patient:innengruppen bereithält.
Dass diese Frage bereits die Beteiligten in frühen Computerisierungsprojekten beschäftigte, zeigt die Teilnahme zweier DIPAS-Kinderärzte, die eine Spina-Bifida-Ambulanz für eine kontinuierliche Begleitung dieser seltenen angeborenen Fehlbildung des Rückenmarks (auch »Offener Rücken« genannt) aufbauen wollten. Gerade für die langfristige Begleitung von Patient:innen mit einer seltenen Erkrankung erschien eine systematische Dokumentation besonders wichtig. Die Ambulanz ist beispielhaft für die Versorgungsproblematik für Menschen mit seltenen Erkrankungen. Ihre durchschnittliche Diagnosedauer beträgt in Deutschland heute immer noch im Schnitt fünf Jahre.25
Dieses Problem ist bereits seit den 1970er Jahren bekannt und hat die Debatten um die ersten Anamnesebögen mitgeprägt. In Deutschland sind heute in den 2020er Jahren rund vier Millionen Menschen von einer der mehr als 6000 bekannten seltenen Krankheiten betroffen.26 Die Ungleichheit im Dokumentationssystem für Gesundheitsdaten ist für sie eine alltägliche Erfahrung. Aber das Problem geht über seltene Erkrankungen hinaus. Viele Datenbanken basieren etwa auf klinischen Datensätzen, in denen Frauen zunächst nicht mit angelegt waren – ein Umstand, der jetzt erst im Kontext der Gender-Data-Gap-Debatte zunehmend zum Thema wird.27
Insbesondere, da nun große Datenmengen zunehmend über KI ausgewertet werden sollen, stellt sich die Frage, ob in den Datensätzen ein sogenannter Bias vorliegt, also eine einseitige Interpretation der Daten, und inwieweit alte Datensätze diesen auch als »black box« verstecken.28 Diagnosekriterien, die an bestimmten Patient:innengruppen entwickelt wurden, versagen bei anderen. Das ist kein Problem der Digitalisierung allein, aber durch die Codierung in algorithmische Systeme wurde es stabilisiert und schwerer korrigierbar gemacht. Was als digitales »Empowerment« verkauft wird, ist oftmals vielmehr eine Reproduktion bestehender Ungleichheiten,29 insbesondere für Gruppen, die ohnehin keinen selbstbestimmten und informierten Zugang zu bestimmten digitalen Medien haben.30
Die in der Frage medizinischer Dokumentation sichtbar werdende digitale Ungleichheit besteht hingegen nicht primär im Zugang zu technischen Systemen. Sie entsteht dort, wo Dokumentationsstandards darüber entscheiden, welche überhaupt als Informationen erfasst werden können. Die zentrale Frage lautet daher nicht nur, wer Zugang zum System hat, sondern für wen das System eine Sprache bereithält. Bereits in den 1970er Jahren war vielen Beteiligten bewusst, dass standardisierte Kategorien nicht alle Krankheitsverläufe gleichermaßen erfassen konnten. Genau hier setzte die Debatte um den »Freitext« an.
Klartext als Widerstand – und seine Grenzen
Gerade weil sich standardisierte Dokumentationsformen zunehmend durchsetzten, wurde zugleich sichtbar, was sie nicht leisten konnten. Viele Krankheitsverläufe, Verdachtsdiagnosen oder individuelle Beobachtungen ließen sich nicht ohne Weiteres in vorgegebene Kategorien überführen. Als Antwort auf diese Grenzen entstand bereits in den frühen Projekten der 1970er Jahre die Forderung nach »Klartext« oder »Freitext«: der Möglichkeit, standardisierte Angaben durch freie Beschreibungen zu ergänzen.
Das DIPAS-Projekt selbst wurde 1975 nach internen Konflikten (und gegen den Willen der beteiligten Ärzt:innen) eingestellt, nachdem es ursprünglich in ein größeres bundesrepublikanisches Netzwerkvorhaben namens DOMINIG31 integriert werden sollte.32 Seine konkreten Dokumentationslösungen setzten sich daher nicht unmittelbar durch.
Und so blieb der Freitext eine kontroverse Causa. Besonders deutlich zeigte sich dies im Bereich des Arztbriefs. In einem Beitrag im Deutschen Ärzteblatt von 1985 wurde betont, dass gute Arztbriefsysteme zwar standardisierte Passagen enthalten, zugleich aber auch Raum lassen sollten für »Gedanken und Überlegungen, in die die persönliche Erfahrung des Autors« einfließen könne.33 Immer wieder wurde darauf verwiesen, dass medizinische Dokumentation mehr leisten müsse als die bloße Zuordnung von Symptomen zu Kategorien. Auch Wolfgang Giere verstand den Freitext von Beginn an als einen zentralen Bestandteil einer humanen Medizin: »Ein Arzt kann auch Dinge, die er noch nie gesehen hat, kreativ benennen. Darin steckt der Fortschritt der Medizin«, resümierte er.34
Die Geschichte des Freitexts verweist damit auf ein Grundproblem der medizinischen Dokumentation: Standardisierung macht Informationen vergleichbar, Freitext macht sie offen für Neues. Beides ist notwendig. Viele Ärzt:innen führen bis heute Akten mit freien Notizen oder ergänzen standardisierte Arztbriefe um individuelle Beobachtungen. Die Computerisierung der Medizin erwies sich daher nie als einfacher Übergang von Sprache zu Code. Vielmehr bestand sie in einer fortwährenden Suche nach einem Gleichgewicht zwischen Standardisierung und Offenheit.
Dieses Spannungsverhältnis prägt die Diskussion bis heute. Internationale Terminologiestandards wie SNOMED CT (Systematized Nomenclature of Medicine Clinical Terms) versuchen, zwischen codierten und freien Sprachformen zu vermitteln und medizinisches Wissen differenzierter abzubilden als herkömmliche Klassifikationssysteme wie der ICD-Code.35 Mit neuen KI-Anwendungen und der automatisierten Auswertung von Freitextakten ist zudem die Hoffnung verbunden, dass sich die Vorteile beider Ansätze stärker miteinander verbinden lassen. Large Language Models versprechen, Freitextinformationen maschinell auszulesen und für Dokumentationssysteme nutzbar zu machen.36 KI-Systeme greifen damit ein Problem auf, das bereits DIPAS beschäftigte: Wie lässt sich die Offenheit medizinischer Sprache digital verarbeiten? Auch moderne Modelle müssen entscheiden, welche Informationen und Begriffe für ein System relevant sind.37 Jede Normierung bleibt eine Entscheidung darüber, wessen Erfahrungen, Beobachtungen und Begriffe zur Grundlage eines Systems werden.
Der Mensch: mehr als die Summe seiner Symptome
Die elektronische Patientenakte, die in Deutschland seit 2021 stufenweise für Kliniken und Praxen eingeführt wird, verwirklicht in vielerlei Hinsicht jene Vision, die Giere, Schaefer und ihre Kolleg:innen bereits in den 1970er Jahren entwarfen: die sektorenübergreifende Speicherung und Weitergabe medizinischer Informationen. Zugleich bestehen viele der damals diskutierten Probleme bis heute fort. Auch moderne Informationssysteme beruhen auf Formularen, Codes und Klassifikationen, die entscheiden, welche Informationen sichtbar werden und welche schwer dokumentierbar bleiben. Die Frage, was dokumentiert wird und was nicht, ist damit heute politischer denn je.
Hier schließt sich die eingangs gestellte Frage an, für wen Anamnesebögen eigentlich sind. Die Geschichte der computergestützten Medizin legt nahe, dass sie nie nur für Patient:innen oder Ärzt:innen bestimmt waren. Für Patient:innen strukturieren sie Erinnerungen an Beschwerden, Vorerkrankungen oder Medikationen.38 Für Ärzt:innen bilden sie eine (mal besser, mal schlechter funktionierende) Grundlage der Dokumentation, Kommunikation und Diagnostik.39 Zugleich sind sie eine Grundlage für Informationssysteme, die ihre Inhalte speichern, vergleichen, übertragen und auswerten sollen. Der Anamnesebogen ist damit nicht nur ein Hilfsmittel des Arzt-Patienten-Gesprächs, sondern auch ein zentrales Übersetzungsmedium zwischen individueller Erfahrung und digitaler Infrastruktur.
Je stärker medizinische Informationen vernetzt und ausgewertet werden, desto bedeutsamer wird jedoch die Frage, was dokumentierbar bleibt und was aus dem Blick gerät. Die Geschichte der medizinischen Dokumentation ist daher weder als Sieg der Standardisierung noch als Triumph des Freitexts zu verstehen, sondern als fortwährende Aushandlung zwischen Vergleichbarkeit und Offenheit.
Der amerikanische Medizinhistoriker und praktizierende Mediziner Andrew S. Lea hat am Beispiel der USA beschrieben, wie die digitale Medizin immer wieder dazu tendiert, »die Kunst der Medizin in eine Wissenschaft zu verwandeln« – sie einzugrenzen, zu codieren und letztlich zu computerisieren.40 Was dabei leicht aus dem Blick gerät, sind die sozialen, moralischen, persönlichen und kulturellen Dimensionen medizinischer Praxis. Die Geschichte der Anamnesebögen zeigt deshalb, dass digitale Ungleichheit nicht erst beim Zugang zu Technologien beginnt. Sie entsteht bereits dort, wo Dokumentationssysteme festlegen, welche Erfahrungen, Symptome oder Krankheitsverläufe überhaupt in Daten übersetzt werden können. Standardisierung bleibt eine Voraussetzung moderner Medizin. Die historische Herausforderung besteht jedoch darin, ihre Vorteile nutzbar zu machen, ohne diejenigen aus dem Blick zu verlieren, die nicht in die vorgesehenen Kategorien passen. Der Mensch ist mehr als die Summe seiner digital dokumentierten Symptome.
Footnotes
-
1
Prof. Dr. Wolfgang Giere war ein deutscher Medizininformatiker, der besonders im Bereich der elektronischen Medizindokumentation und durch diverse Anwendungsprojekte wesentliche Pionierarbeit im deutschsprachigen Raum geleistet hat. Er erzählt über diese Arbeit u.a. in seinen Memoiren: Wolfgang Giere, Bollerwagen mit Dynamo. Erlebte Industrie- und Technikgeschichte, Offenbach 2011, online https://fitg.de/fileadmin/FITG-Buch/111123_abwg105_web.pdf. Ergänzt werden solche Bestände heute durch die Bibliothek der Medizinischen Informatik in Göttingen, mein Dank gilt hier dem ehemaligen Direktor des Instituts, Prof. Dr. Otto Rienhoff, der mir die Arbeit dort ermöglicht hat, digitale Archive des Journals MDI (MDI, mdi-digital, URL: https://mdi-digital.de/archiv/) sowie die Sammlungen verschiedener Arbeitsgruppen der GMDS (GMDS, Verbundwebseite, URL: https://www.gmds.de).
-
2
Ich bekam die Erlaubnis, diese Bestände zu sichten, nachdem wir uns für einige Experteninterviews zu seiner Arbeit an der DKD und mit DIPAS getroffen hatten.
-
3
Deutsches Mikrofilm-Institut, Sammlung ORDAB-5115-1, Wolfgang Giere und Otfrid P. Schaefer: Einführung der Datenverarbeitung in die Ärztliche Praxis, 1972.
-
4
Peter Hipp, Anamnesebogen in der ärztlichen Praxis, in: Deutsches Ärzteblatt 16/1974, S. 1173-1178, hier S. 1178, online https://api.aerzteblatt.de/pdf/71/16/a1173.pdf.
-
5
Deutsches Mikrofilm-Institut, Sammlung ORDAB-0021, Protokoll Interview Hessischer Rundfunk / Schaefer 23.03.1973, gesendet im 2. Programm, Freitag 23.03.1973 zwischen 14.30 und 15.00 Uhr.
-
6
Deutsches Mikrofilm-Institut, Sammlung ORDAB-0018, Zwischenbericht J. Stauder 14.03.1974.
-
7
Albin Proppe, Datenverarbeitung und Medizin: Ein Überblick, in: N. Hollberg/B. Pleuss/H. Rittersbacher (Hg.), Computer: Aufgaben im Gesundheitswesen, Berlin 1973, S. 1-11, hier S. 5.
-
8
»EDV in der Arztpraxis – Beratungsstelle des Zentralinstituts«, in: Deutsches Ärzteblatt 18/1975, S. 1260, online https://www.aerzteblatt.de/archiv/edv-in-der-arztpraxis-beratungsstelle-des-zentralinstituts-e2460df6-d96c-4b57-aa40-6ec88dface2d; PC-Beilage: Heike E. Krüger-Brand, PraxisComputer: 20 Jahre EDV in der Arztpraxis, in: Praxis 1/2004 des Deutschen Ärzteblatts, S. 18-21, online https://www.aerzteblatt.de/archiv/praxiscomputer-20-jahre-edv-in-der-arztpraxis-1f799db4-55cc-456c-8b98-b89c13ccdf8b; Adaption der Computertechnik u.a.: Erhard Geiss, EDV-Anwendung in der Arztpraxis: Marktsituation und Entwicklungstrends, in: Deutsches Ärzteblatt 87 (47), 1990, S. A-3759–A-3760, online https://www.aerzteblatt.de/archiv/edv-anwendung-in-der-arztpraxis-marktsituation-und-entwicklungstrends-b5194603-931b-4a8e-a54f-b5ceb99cdd9c.
-
9
Gesetz- und Verordnungsblatt für das Land Hessen: Teil I – Datenschutzgesetz, Amtssache 1Y 3228A, 12.10.1970, S. 625-628, online https://starweb.hessen.de/cache/GVBL/1970/00041.pdf.
-
10
Bundesverfassungsgericht, Urteil vom 15. Dezember 1983, online https://www.bundesverfassungsgericht.de/SharedDocs/Entscheidungen/DE/1983/12/rs19831215_1bvr020983.html; Wilhelm Steinmüller u.a., Drucksache VI/3826, Grundfragen des Datenschutzes. Gutachten im Auftrag des Bundesministeriums des Innern. Juli 1971, online https://dserver.bundestag.de/btd/06/038/0603826.pdf.
-
11
Laura Niebling, States of Glass. Metaphors and Agents of Medical Informational Self-Determination in West Germany’s »Long 1970s«, in: Navigationen 1/2026, S. 143-157 (i.E.); dies., From Colleague Computer to Dr. Google. Doctor-Patient-Relationships, Anthropomorphism and Trusted Technology in German Medical Journals, 1970s-2020s, in: Petra Missomelius u.a. (Hg.), Future of Trust: Trust by Design, Innsbruck 2026 (i.E.).
-
12
Exemplarisch hierfür ist der »Lindauer Datenskandal« in Bayern, bei dem eine Krankenkasse systematisch begonnen hatte Patient:innendaten aus Praxen auszuwerten. Vgl. »Die Presse enthüllt zweifelhafte ›Datenverarbeitung‹: AOK-Aktion: Datenschutz und Schweigepflicht mißachtet«, in: Deutsches Ärzteblatt 73/39, 1976, S. 2417-2418, online https://www.aerzteblatt.de/archiv/die-presse-enthuellt-zweifelhafte-datenverarbeitung-aok-aktion-datenschutz-und-schweigepflicht-missachtet-64c608ab-4ae2-44e9-9f8f-7e565b4f5388.
-
13
Siegfried Kollers (1908-1998) historische Rolle als Pionier der bundesdeutschen (Medizin-)Statistik ist komplex. Er gehörte der »Generation 0« in der Medizininformatik im Nationalsozialismus an, deren Geschichte bislang nur in Ansätzen aufgearbeitet wurde. Vgl. Götz Aly/Karl Heinz Roth, Die restlose Erfassung. Volkszählen, Identifizieren, Aussondern im Nationalsozialismus, Frankfurt a.M. 2019 (zuerst 1984), S. 111-132; Jutta Wietog, Volkszählungen unter dem Nationalsozialismus. Eine Dokumentation zur Bevölkerungsstatistik im Dritten Reich, Berlin 2001; Sigrid Stöckel, Sozialhygiene und Rassenhygiene am Beispiel der Medizinalstatistik in Berlin, in: Wolfram Fischer u.a. (Hg.), Exodus von Wissenschaften aus Berlin, Berlin 1994, S. 472-494, hier S. 490-493; Norbert Schappacher/Sigrid Oehler-Klein, Siegfried Koller und die neuen Herausforderungen der Statistik im Nationalsozialismus, in: Sigrid Oehler-Klein (Hg.), Die Medizinische Fakultät der Universität Gießen im Nationalsozialismus und in der Nachkriegszeit: Personen und Institutionen, Umbrüche und Kontinuitäten, Stuttgart 2007, S. 247-262, insbes. S. 253, online https://irma.math.unistra.fr/~schappa/NSch/Publications_files/2007c_SOeKNsch.pdf. Hier schließt sich eine größere Frage zur informationellen Selbstbestimmung (von zentralisierten staatlichen Datensammlungen) als historisch informierter Schutzgeste an, die noch nicht umfassend beantwortet wurde.
-
14
Herbert Kuni/Emil Graul, Neue Organisationsformen ärztlicher Tätigkeit, in: Deutsches Ärzteblatt 19/1970, S. 1445-1449, S. 1445, online https://www.aerzteblatt.de/archiv/neue-organisationsformen-aerztlicher-taetigkeit-d6d0a616-3c15-4feb-919d-d8f5b811f765.
-
15
Ebd.
-
16
Gerhard Oberhoffer, Gedanken zu einer gemeinsamen medizinischen Datenbank von Klinik und Praxis, in: Deutsches Ärzteblatt 41/1970, S. 3005-3008, hier S. 3006, online https://www.aerzteblatt.de/archiv/gedanken-zu-einer-gemeinsamen-medizinischen-datenbank-von-klinik-und-praxis-1fbe7634-1a93-42d0-9132-e4b59c46c582.
-
17
Deutsches Mikrofilm-Institut, Sammlung ORDAB-0042, Vortrag auf der 6. DKD-Arbeitstagung Detlef Schalck, Fehlerkontrolle und Dateipflege 07.06.1972. Die Akte enthält zudem diverse Publikationen von Schalck zum Thesaurus und Dokumente zu IATINT.
-
18
Laura Niebling, Ein »preiswerter ›guter Geist‹« – Eine kleine Geschichte der medizinischen Bürokratisierung am Beispiel der computerisierten »Arzthelferin« in der BRD, 1970-2000, in: AugenBlick. Konstanzer Hefte zur Medienwissenschaft 89 (2024), S. 55-73.
-
19
Uwe Mayer-Burk, Datenbanken: Medizinische Informationssysteme der Zukunft, in: Deutsches Ärzteblatt 18/1988, S. A 1310-A 1312, hier S. A 1311, online https://www.aerzteblatt.de/archiv/datenbanken-medizinische-informationssysteme-der-zukunft-0ea21514-3c90-4ee8-b6b3-f93d6afa8f57.
-
20
Hierzu u.a. Christoph Engemann, Medien regieren. Personalausweis und Gesundheitskarte: Identifizierungsmedien in der Geschichte des modernen Staates, Bielefeld 2023.
-
21
Jörg Michaelis, Computerunterstützte Diagnostik – Probleme, Erfahrungen und Entwicklungsaussichten, in: Hans-Joachim Lange/Jörg Michaelis/Karl Überla (Hg.), 15 Jahre Medizinische Statistik und Dokumentation. Aspekte eines Fachgebiets, Berlin 1987, S. 159-180, hier S. 162.
-
22
K.D. Mendelsohn u.a., Sex and Gender Bias in Anatomy and Physical Diagnosis Text Illustrations, in: JAMA. 1994, 272 (16), S. 1267-1270.
-
23
Anna Gladkova/Elena Vartanova/Shi-xu, Introduction, in: dies. (Hg.), Digital Inequality – Studies in Cultural Communication, London 2024, S. 2-7, hier S. 2, online https://doi.org/10.4324/9781032672250.
-
24
Jan van Dijk, The Digital Divide, Cambridge 2020.
-
25
Mirjam Martin, Seltene Erkrankungen: Häufig ohne Diagnose, in: Deutsches Ärzteblatt 4/2024, S. A 222-A 224, online https://www.aerzteblatt.de/archiv/seltene-erkrankungen-haeufig-ohne-diagnose-f00b335a-4e69-4861-acef-756245b34a0d.
-
26
Bundesministerium für Gesundheit, Seltene Erkrankungen, 15.01.2026, online https://www.bundesgesundheitsministerium.de/themen/praevention/gesundheitsgefahren/seltene-erkrankungen.
-
27
»Digitalisierung: Genderbias in Daten muss beendet werden«, in: Deutsches Ärzteblatt, 18.10.2023, online https://www.aerzteblatt.de/news/digitalisierung-genderbias-in-daten-muss-beendet-werden-86e72634-5609-4ea1-89dd-7d9370df228a.
-
28
Hanhui Xu/Kyle M.J. Shuttleworth, Medical Artificial Intelligence and the Black Box Problem: A View Based on the Ethical Principle of »Do No Harm«, in: Intelligent Medicine 4 2024, H. 1, S. 52-57, online https://doi.org/10.1016/j.imed.2023.08.001.
-
29
Jörg Scheffer, Mirrored Spaces. Social Inequality in the Digital Age, Wiesbaden 2024, online https://link.springer.com/book/10.1007/978-3-658-42793-1.
-
30
Vgl. die Beiträge in: Eszter Hargittai (Hg.), Handbook of Digital Inequality, Cheltenham 2021.
-
31
Zu DOMINIG II in Hessen: Laura Niebling, A Problem Consciousness for the Information Age: Automated Hospitals as Rational Infrastructures in 1970s West Germany, in: IEEE – Annals for the History of Computing: Computing and the Built Environment 2026 (i.E.).
-
32
Deutsches Mikrofilm-Institut, Sammlung ORDAB-4070-B, Brief Schwartz/Brenner an GFS 22.08.1975.
-
33
A. Habermehl, Automatische Arztbriefschreibung, in: Deutsches Ärzteblatt 6/1985, S. 333-337, hier S. 333, online https://www.aerzteblatt.de/archiv/automatische-arztbriefschreibung-145482fa-79f7-494a-acab-a14d1e49bbe3.
-
34
Expertengespräch von Wolfgang Giere mit der Autorin, 03.06.2023.
-
35
Sylvia Thun/Carolin Stellmach, Struktur und Herausforderungen der Medizininformatik in Deutschland, in: Curare 45 (2022), H. 1, S. 64-76.
-
36
Richard Noll u.a., De-Identification of Free-Text Medical Records Using Large Language Models, in: Studies in Health Technology and Informatics Bd. 336), 2026, S. 809-813, online https://ebooks.iospress.nl/doi/10.3233/SHTI260291.
-
37
Adam Zewe, Toward a Smarter Electronic Health Record, in: MIT News Office, 23.09.2021, https://news.mit.edu/2021/medknowts-electronic-health-record-0923.
-
38
Angelika Redder, Eine alltägliche klinische Anamnese, in: dies./Ingrid Wiese (Hg.), Medizinische Kommunikation. Diskurspraxis, Diskursethik, Diskursanalyse. Opladen, 1994, S. 171-199, hier S. 175.
-
39
Thomas Böhmeke, Von schräg unten: Anamnesebogen, in: Deutsches Ärzteblatt 35-36/2017, S. 104, online https://www.aerzteblatt.de/archiv/von-schraeg-unten-anamnesebogen-5978f02a-eca5-4187-a6e1-e1e86a2ec13c.
-
40
Andrew S. Lea, Digitizing Diagnosis. Medicine, Minds, and Machines in Twentieth-Century America, Baltimore 2023, S. 2 [übersetzt aus dem Englischen L.H.].
License